جستوجوی سبک برای یک پروژه واقعی
برای دانشنامه کوچک، ابزار آموزشی یا فهرست آفلاین اسناد، همیشه به یک موتور جستوجوی جدا نیاز نداریم. FTS5 امکان ایجاد جدول متن قابل جستوجو را در SQLite فراهم میکند. نگهداری متن و ایندکس در یک فایل، شروع پروژه را ساده میکند؛ اما انتخاب آن باید با تعداد سند، اندازه متن، همزمانی نوشتن و نیاز به مجوز دسترسی سنجیده شود. نمونه این مقاله در حافظه اجرا میشود تا فایل موجود کاربر را تغییر ندهد.
در زبان فارسی، پیش از رتبهبندی باید شکل نوشتاری را بررسی کنیم. تفاوت ی و ک عربی با معادل فارسی، نیمفاصله و فاصلههای تکراری میتواند پرسش و سند را از هم دور کند. نسخه نمایشی ی و ک را یکسان و نیمفاصله را به فاصله تبدیل میکند. این تصمیم برای همه واژهها بهترین پاسخ نیست؛ در پروژه واقعی، متن اصلی را جدا نگه دارید و اثر هر تبدیل را روی مجموعه پرسشهای خود بسنجید.
کیفیت متن پیش از تنظیم رتبه
FTS5 یک ابزار تحلیل کامل زبان فارسی نیست. tokenizer پیشفرض unicode61 مرز واژهها را تشخیص میدهد، اما نباید از آن انتظار ریشهیابی فارسی یا فهم هممعنایی داشته باشیم. اگر کاربر «پرداخت» بنویسد و سند فقط «تسویه» داشته باشد، یکسانسازی حروف مسئله را حل نمیکند. میتوانید فرهنگ واژههای کنترلشده یا جستوجوی ترکیبی را بعداً ارزیابی کنید؛ ابتدا خطاهای واقعی را ثبت کنید تا پیچیدگی اضافه برای یک مشکل خیالی ساخته نشود.
نمونه کد سندهای کوچک را وارد جدول مجازی میکند و پرسش را با پارامتر bind میفرستد. پارامترگذاری جلوی تزریق SQL را میگیرد، ولی زبان MATCH همچنان دستورهای جستوجوی خودش را دارد. برای یک عبارت ساده کاربر، آن را داخل گیومه دوتایی قرار داده و گیومه داخلی را escape میکنیم. اگر محصول شما عملگرهای پیشرفته ارائه میدهد، باید نحو مجاز و پیام خطای قابل فهم را جدا طراحی کنید.
تابع bm25 برای مرتبکردن نتیجه به کار میرود و در این کاربرد مقدار کمتر جلوتر قرار میگیرد. با دو سند نمیتوان کیفیت را اثبات کرد. مجموعهای از پرسشهای املایی، عنوان دقیق، عبارت بدون نتیجه و واژههای نیمفاصلهدار بسازید. ثبت کنید سند مطلوب در چند نتیجه اول دیده میشود و آیا متن نمایشی به کاربر اجازه تشخیص نتیجه مناسب را میدهد. هر نوع snippet را در HTML بهصورت امن نمایش دهید.
نمونه کد و روش بررسی
پیشنیاز و خروجی مورد انتظار در توضیح مثال آمده است. ابتدا نمونه را در محیط آزمایشی اجرا کنید و سپس آن را با داده و محدودیتهای پروژه خود تطبیق دهید.
1. Python با SQLite دارای افزونه FTS5
import sqlite3

def normalize(text):
    return " ".join(text.replace("ي", "ی").replace("ك", "ک")
                    .replace("\u200c", " ").split())

def phrase(text):
    return '"' + text.replace('"', '""') + '"'

db = sqlite3.connect(":memory:")
db.execute("CREATE VIRTUAL TABLE docs USING fts5(title, body)")
db.executemany("INSERT INTO docs VALUES (?, ?)", [
    ("پرداخت", normalize("راهنمای پرداخت اینترنتی")),
    ("ارسال", normalize("پیگیری ارسال سفارش")),
])
query = normalize("پرداخت")
if query:
    rows = db.execute(
        "SELECT title FROM docs WHERE docs MATCH ? "
        "ORDER BY bm25(docs) LIMIT 5", (phrase(query),)
    ).fetchall()
    print(rows)
خروجی باید فقط عنوان پرداخت را نشان دهد. این مثال ثبت مجوز دسترسی یا همگامسازی جدول بیرونی را پیادهسازی نمیکند. خطای no such module: fts5 یعنی SQLite همین محیط، افزونه لازم را ندارد.
2. جدول اصلی و ایندکس FTS5 با همگامسازی تغییرات
این SQL را در یک دیتابیس آزمایشی خالی دارای FTS5 اجرا کنید. وقتی متن اصلی در جدول معمولی است، اضافهکردن جدول جستوجو بهتنهایی کافی نیست؛ INSERT، UPDATE و DELETE باید ایندکس را هم تغییر دهند.
CREATE TABLE source_docs(id INTEGER PRIMARY KEY, title TEXT, body TEXT);
CREATE VIRTUAL TABLE search_docs USING fts5(
    title, body, content='source_docs', content_rowid='id'
);
CREATE TRIGGER docs_insert AFTER INSERT ON source_docs BEGIN
    INSERT INTO search_docs(rowid,title,body)
    VALUES(new.id,new.title,new.body);
END;
CREATE TRIGGER docs_delete AFTER DELETE ON source_docs BEGIN
    INSERT INTO search_docs(search_docs,rowid,title,body)
    VALUES('delete',old.id,old.title,old.body);
END;
CREATE TRIGGER docs_update AFTER UPDATE ON source_docs BEGIN
    INSERT INTO search_docs(search_docs,rowid,title,body)
    VALUES('delete',old.id,old.title,old.body);
    INSERT INTO search_docs(rowid,title,body)
    VALUES(new.id,new.title,new.body);
END;
INSERT INTO source_docs VALUES(1,'Payment guide','refund policy');
SELECT rowid,title FROM search_docs WHERE search_docs MATCH 'refund';
UPDATE source_docs SET body='delivery policy' WHERE id=1;
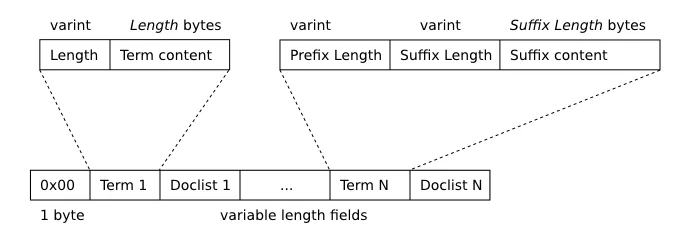
SELECT count(*) FROM search_docs WHERE search_docs MATCH 'refund';جستوجوی اول ردیف 1 را میدهد و شمارش آخر پس از تغییر متن باید صفر شود. برای جدول اصلیِ از قبل پُر، پس از ایجاد ساختار باید rebuild انجام شود. نمودار کاور ساختار قدیمی FTS را توضیح میدهد و بهعنوان بنچمارک یا قالب دقیق FTS5 استفاده نشده است.
3. تابع جستوجو با عبارت ساده و ورودی خالی
نمونه زیر مستقل است و پایگاه داده حافظهای خودش را میسازد. محدودکردن LIMIT و تبدیل ورودی به عبارت نقلقولشده، رفتار یک کادر جستوجوی ساده را مشخص میکند؛ این رابط عمداً عملگرهای پیشرفته را نمیپذیرد.
import sqlite3

def normalize(value):
    return " ".join(value.replace("ي", "ی").replace("ك", "ک")
                    .replace("\u200c", " ").split())

def search(db, user_query):
    query = normalize(user_query)
    if not query:
        return []
    phrase = '"' + query.replace('"', '""') + '"'
    return db.execute(
        "SELECT title, body FROM docs WHERE docs MATCH ? "
        "ORDER BY bm25(docs) LIMIT ?", (phrase, 5)
    ).fetchall()

db = sqlite3.connect(":memory:")
db.execute("CREATE VIRTUAL TABLE docs USING fts5(title,body)")
db.execute("INSERT INTO docs VALUES(?,?)",
           ("پرداخت", normalize("راهنمای پرداخت اینترنتی")))
assert search(db, "  ") == []
assert search(db, "پرداخت")[0][0] == "پرداخت"
assert search(db, 'a "quoted" phrase') == []
print("Search checks passed")
db.close()
باید Search checks passed چاپ شود. در API واقعی، اندازه پرسش و تعداد نتیجه را در سمت سرور محدود کنید و شناسه سازمان را از هویت معتبر بگیرید؛ ورودی قابل تغییر کاربر مرز مجوز را تعیین نمیکند.
4. نمایش امن نتیجه و آزمون یکسانسازی فارسی
بازیابی درست باید با نمایش درست همراه شود. این مثال فقط متن عنوان و بدنه را وارد HTML میکند و همه محتوای برگشتی را متن غیرقابل اعتماد میداند؛ حتی وقتی سند از دیتابیس خودمان آمده است.
from html import escape
def normalize(value):
return " ".join(value.replace("ي", "ی").replace("ك", "ک")
.replace("\u200c", " ").split())
def result_card(title, body):
return "<article><h3>" + escape(title) + "</h3><p>" + escape(body) + "</p></article>"
assert normalize("كتاب") == normalize("کتاب")
assert normalize("می\u200cرود") == normalize("می رود")
markup = result_card("<script>unsafe</script>", "راهنمای پرداخت")
assert "<script>" not in markup
assert "<script>" in markup
print(markup)دو assertion اول قرارداد یکسانسازی را ثبت میکنند و دو مورد بعدی نشان میدهند تگ موجود در سند اجرا نمیشود. برای برجستهسازی واژه، ابتدا متن را امن کنید و سپس فقط نشانگذاری کنترلشده خود برنامه را اضافه کنید؛ خروجی خام highlight را بیبررسی به innerHTML ندهید.
چه زمانی این معماری را گسترش دهیم؟
اگر حجم نوشتن یا نیاز به توزیع افزایش پیدا کرد، زمان بازبینی معماری است. پیش از مهاجرت، هزینه همگامسازی، پشتیبانگیری و بازسازی ایندکس را اندازه بگیرید. در یک پروژه دانشجویی، تحویل خوب فقط دکمه جستوجو نیست: داده نمونه، قواعد یکسانسازی، آزمونهای زبان فارسی و توضیح محدودیتها باید همراه کد باشند. این موارد نشان میدهند نتیجه تصادفی نیست و میتوان آن را بعداً بهتر کرد.
چکلیست اجرای عملی
- وجود FTS5 را در همان runtime اجرا بررسی کنید.
- متن اصلی و متن یکسانسازیشده را جدا نگه دارید.
- پارامتر SQL و نحو MATCH را دو موضوع مستقل بدانید.
- کیفیت پرسشهای فارسی را با داده واقعی بسنجید.
منابع
در دانشنامه آیوان نیز میتوانید دربارهٔ جستوجوی ترکیبی متن و معنا بخوانید.
تدوین و راهنمای عملی: دانشنامه لیان.