فشردهسازی را با نوع داده انتخاب کنید
فایل رخداد یا خروجی JSON ممکن است حجیم باشد، ولی انتخاب الگوریتم فقط با کوچکترین عدد حجم تصمیم خوبی نیست. زمان فشردهسازی، زمان بازیابی، حافظه و سازگاری مصرفکننده هم اهمیت دارند. ماژول compression.zstd از Python 3.14 مسیر استانداردی برای کار با Zstandard فراهم میکند. پیش از استفاده در محصول، در دسترسبودن آن را در همان build پایتون محیط مقصد بررسی کنید.
ابتدا نمونهای نماینده از داده واقعی انتخاب کنید. متن تکراری معمولاً بهتر از داده از قبل فشردهشده کوچک میشود؛ بنابراین مثال تکرارشونده این مقاله فقط درستبودن مسیر را نشان میدهد، نه نسبت قابل وعده برای پروژه شما. در نمونه، متن فارسی ابتدا به UTF-8 تبدیل میشود و بعد فشرده میشود. هنگام بازکردن، bytes باید دوباره با همان کدگذاری به متن تبدیل شود.
آزمایش کوچک پیش از تغییر خط انتقال
round-trip یعنی داده پس از فشردهسازی و بازیابی دقیقاً برابر نسخه اولیه باشد. assertion این مثال چنین چیزی را بررسی میکند، اما خرابی فایل، بازیابی ناقص و شکست نوشتن روی دیسک را پوشش نمیدهد. در سامانه واقعی، checksum و انتشار اتمیک فایل میتوانند بخشی از قرارداد باشند. فشردهسازی رمزگذاری نیست؛ فایل کوچکشده همچنان میتواند اطلاعات محرمانه را در خود داشته باشد.
برای مقایسه سطحها، همان ورودی را چند بار با شرایط مشابه اجرا کنید و زمان را با ابزار اندازهگیری مناسب ثبت کنید. خواندن فایل از کش سیستمعامل ممکن است نتیجه را تغییر دهد، پس مرحله ورودی و خروجی را از محاسبه اصلی جدا گزارش کنید. نسبت حجم را همراه با زمان و اندازه نمونه بنویسید؛ یک درصد بدون روش اندازهگیری برای تصمیم عملی کافی نیست.
نمونه کامل داده را در حافظه میگذارد و برای فایل نامحدود مناسب نیست. ورودی فشرده ناشناس میتواند پس از بازشدن بسیار بزرگتر شود؛ سرویس دریافت فایل باید سقف خروجی، سهمیه و محدودیت زمان داشته باشد. برای جریانهای بزرگ، API فایل یا پردازش streaming را بررسی کنید و با داده ناقص و قطعشدن جریان آزمایش کنید. حالت خطا بخشی از طراحی است، نه کاری برای پایان پروژه.
نمونه کد و روش بررسی
پیشنیاز و خروجی مورد انتظار در توضیح مثال آمده است. ابتدا نمونه را در محیط آزمایشی اجرا کنید و سپس آن را با داده و محدودیتهای پروژه خود تطبیق دهید.
1. Python 3.14 یا جدیدتر با پشتیبانی compression.zstd
from compression import zstd
raw = ("گزارش نمونه برای آزمایش فشردهسازی\n" * 1000).encode("utf-8")
packed = zstd.compress(raw, level=3)
restored = zstd.decompress(packed)
assert restored == raw
print("Original bytes:", len(raw))
print("Compressed bytes:", len(packed))
print("Round trip:", restored == raw)انتظار Round trip: True داریم؛ عدد حجم به داده و پیادهسازی بستگی دارد. ورودی ساختگی است و داده از اینترنت باز نمیشود. این API یکمرحلهای برای ورودی بزرگ یا ناشناس بدون کنترل منابع کافی نیست.
2. فایل متنی UTF-8 و بازیابی با context manager
برای فایل متن، API متنی را با encoding صریح استفاده کنید. with بستهشدن جریان و تکمیل خروجی فشرده را پیش از خواندن تضمین میکند. نمونه در پوشه موقت خودش اجرا میشود و فایل کاربر را بازنویسی نمیکند.
# Python 3.14+
from compression import zstd
from pathlib import Path
from tempfile import TemporaryDirectory

text = "رویداد آزمایشی: سفارش ثبت شد\n" * 100
with TemporaryDirectory() as folder:
    path = Path(folder) / "events.txt.zst"
    with zstd.open(path, "wt", encoding="utf-8", level=3) as output:
        output.write(text)
    with zstd.open(path, "rt", encoding="utf-8") as source:
        restored = source.read()
    assert restored == text
    print("Compressed file bytes:", path.stat().st_size)
    print("UTF-8 file round trip passed")
باید UTF-8 file round trip passed چاپ شود. برای تولید فایل نهایی، ابتدا در نام موقت همان فایلسیستم بنویسید و پس از تأیید خروجی، با روش اتمیک مناسب محیط آن را منتشر کنید؛ گیرنده نباید فایل نیمهنوشته را نتیجه کامل تصور کند.
3. بازیابی با سقف خروجی به جای read نامحدود
حجم فایل فشرده معیار کافی برای حجم پس از بازشدن نیست. این تابع پیش از تحویل نتیجه کامل، سقف بایت خروجی را میسنجد و یک بایت اضافه میخواند تا عبور از سقف مشخص شود.
# Python 3.14+; a decompressed-output bound, not a sandbox.
from compression import zstd
from io import BytesIO

def decompress_bounded(blob, max_bytes):
    if max_bytes < 0:
        raise ValueError("max_bytes must be non-negative")
    chunks, total = [], 0
    with zstd.open(BytesIO(blob), "rb") as stream:
        while True:
            chunk = stream.read(min(65536, max_bytes - total + 1))
            if not chunk:
                return b"".join(chunks)
            total += len(chunk)
            if total > max_bytes:
                raise ValueError("decompressed output exceeds limit")
            chunks.append(chunk)

packed = zstd.compress(b"x" * 100_000)
assert decompress_bounded(packed, 100_000) == b"x" * 100_000
try:
    decompress_bounded(packed, 1000)
except ValueError as error:
    print("Rejected:", error)
else:
    raise AssertionError("Expected the output limit to reject this input")
آزمون اول باید موفق و آزمون دوم با پیام Rejected تمام شود. این سقف فقط خروجی تحویلی را محدود میکند؛ حافظه داخلی decoder، زمان CPU و ورودی فایل نیز به محدودیت مستقل نیاز دارند. برای دریافت داده ناشناس، محدودیت پنجره و جداسازی منابع را مطابق محیط اجرا بررسی کنید.
4. اندازهگیری چند سطح روی فایل خودتان
به جای وعده درصد ثابت، python benchmark_zstd.py events.jsonl را روی نمونه نماینده و غیرحساس اجرا کنید. خواندن فایل بیرون زمانسنج است و میانه پنج اجرا گزارش میشود؛ بنابراین این آزمون زمان خود الگوریتم در حافظه را تقریب میزند، نه کل خط انتقال دیسک و شبکه را.
# benchmark_zstd.py INPUT_FILE; Python 3.14+
from compression import zstd
from pathlib import Path
from statistics import median
from time import perf_counter
import sys

path = Path(sys.argv[1])
if path.stat().st_size > 32 * 1024 * 1024:
    raise SystemExit("Use a representative sample up to 32 MiB")
raw = path.read_bytes()
if not raw:
    raise SystemExit("Use a non-empty file")

for level in (1, 3, 9):
    encode, decode = [], []
    for _ in range(5):
        start = perf_counter()
        packed = zstd.compress(raw, level=level)
        encode.append((perf_counter() - start) * 1000)
        start = perf_counter()
        restored = zstd.decompress(packed)
        decode.append((perf_counter() - start) * 1000)
        assert restored == raw
    print({"level": level, "bytes": len(packed),
           "stored_percent": round(100 * len(packed) / len(raw), 2),
           "encode_ms": round(median(encode), 3),
           "decode_ms": round(median(decode), 3)})
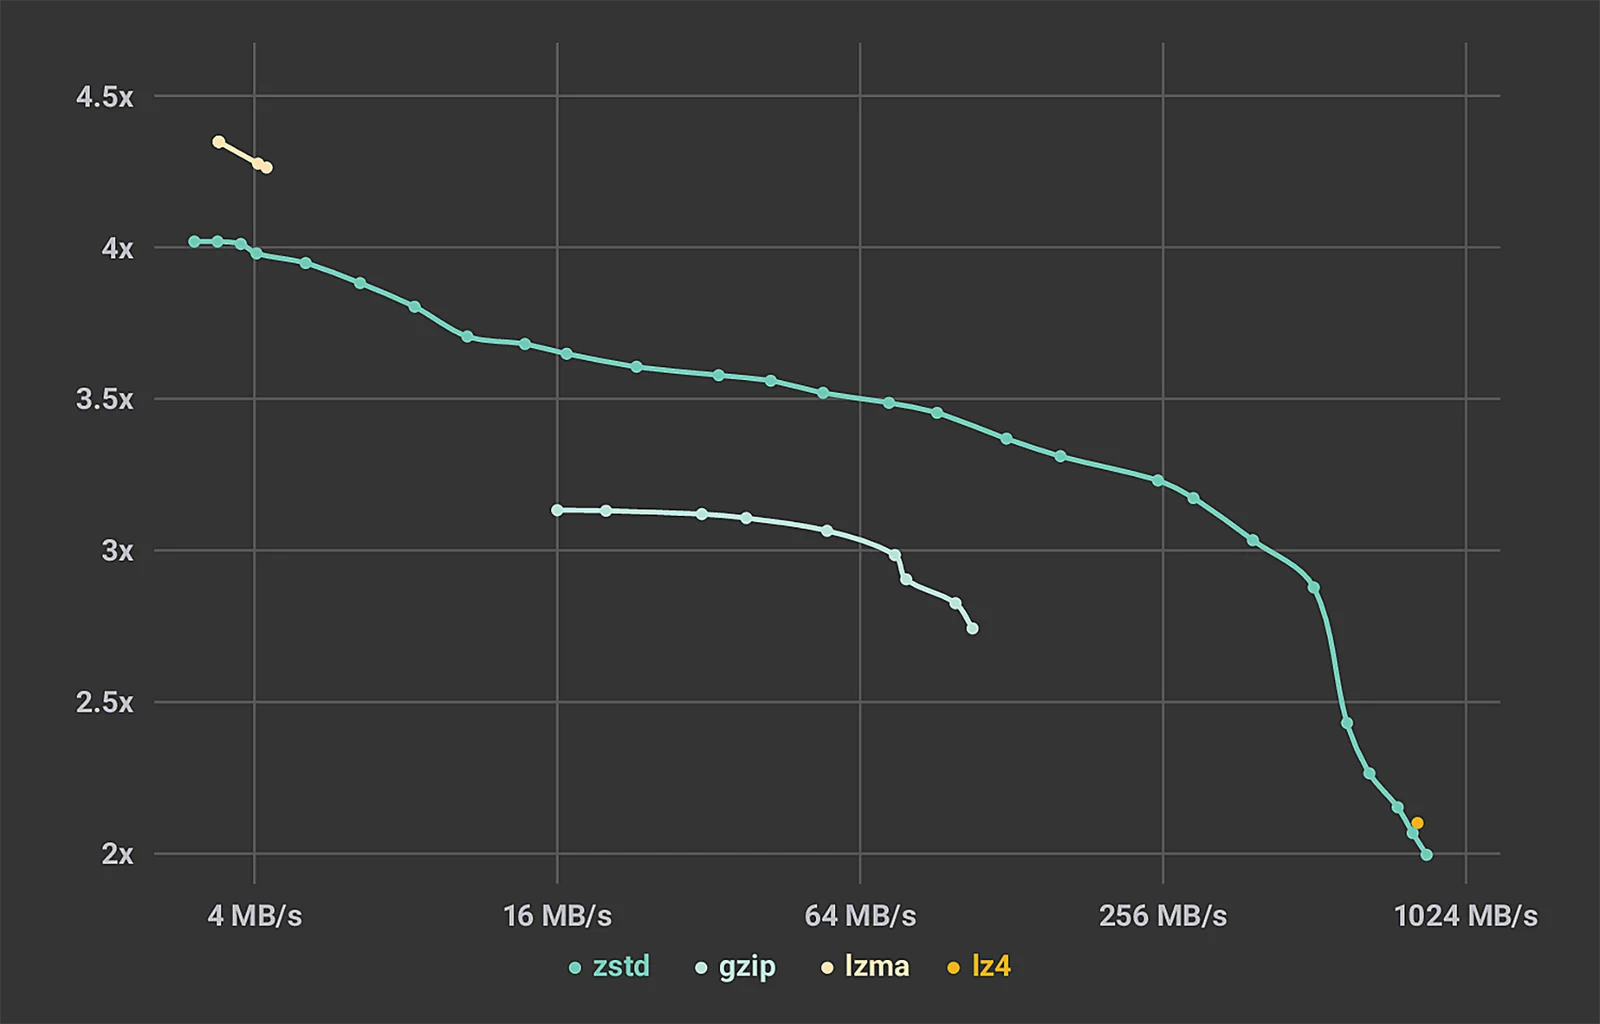
جدول خروجی، هزینه رمزگذاری و بازکردن را کنار اندازه میگذارد. نمودار کاور از بنچمارک تاریخی ناشر آمده و پیشبینی نتیجه این فایل نیست. با تغییر داده، سختافزار یا نسخه کتابخانه دوباره اندازه بگیرید و پیش از عوضکردن فرمت، سازگاری مصرفکننده را تأیید کنید.
مصرف حافظه و سازگاری گیرنده
قبل از تغییر فرمت آرشیو، بررسی کنید ابزار گیرنده و مسیر بازیابی اضطراری آن را میخوانند. یک فایل کوچک نمونه و دستور بازکردن را همراه قرارداد داده منتشر کنید و نسخه قبلی را برای دوره گذار پشتیبانی کنید. بهترین انتخاب الگوریتم، گزینهای است که در محدودیتهای واقعی شما قابل استفاده و قابل بازیابی باشد؛ نه گزینهای که فقط در یک متن ساختگی رکورد حجم میزند.
چکلیست اجرای عملی
- دسترسی ماژول در build مقصد بررسی شود.
- round-trip با داده واقعی آزموده شود.
- زمان، حافظه و حجم همزمان گزارش شوند.
- برای بازکردن ورودی نامطمئن سقف منابع تعیین شود.
منابع
تدوین و راهنمای عملی: دانشنامه لیان.